

AI & Machine Learning
Computer vision voor kwaliteitscontrole: implementatie en kosten voor productie
Gepubliceerd:
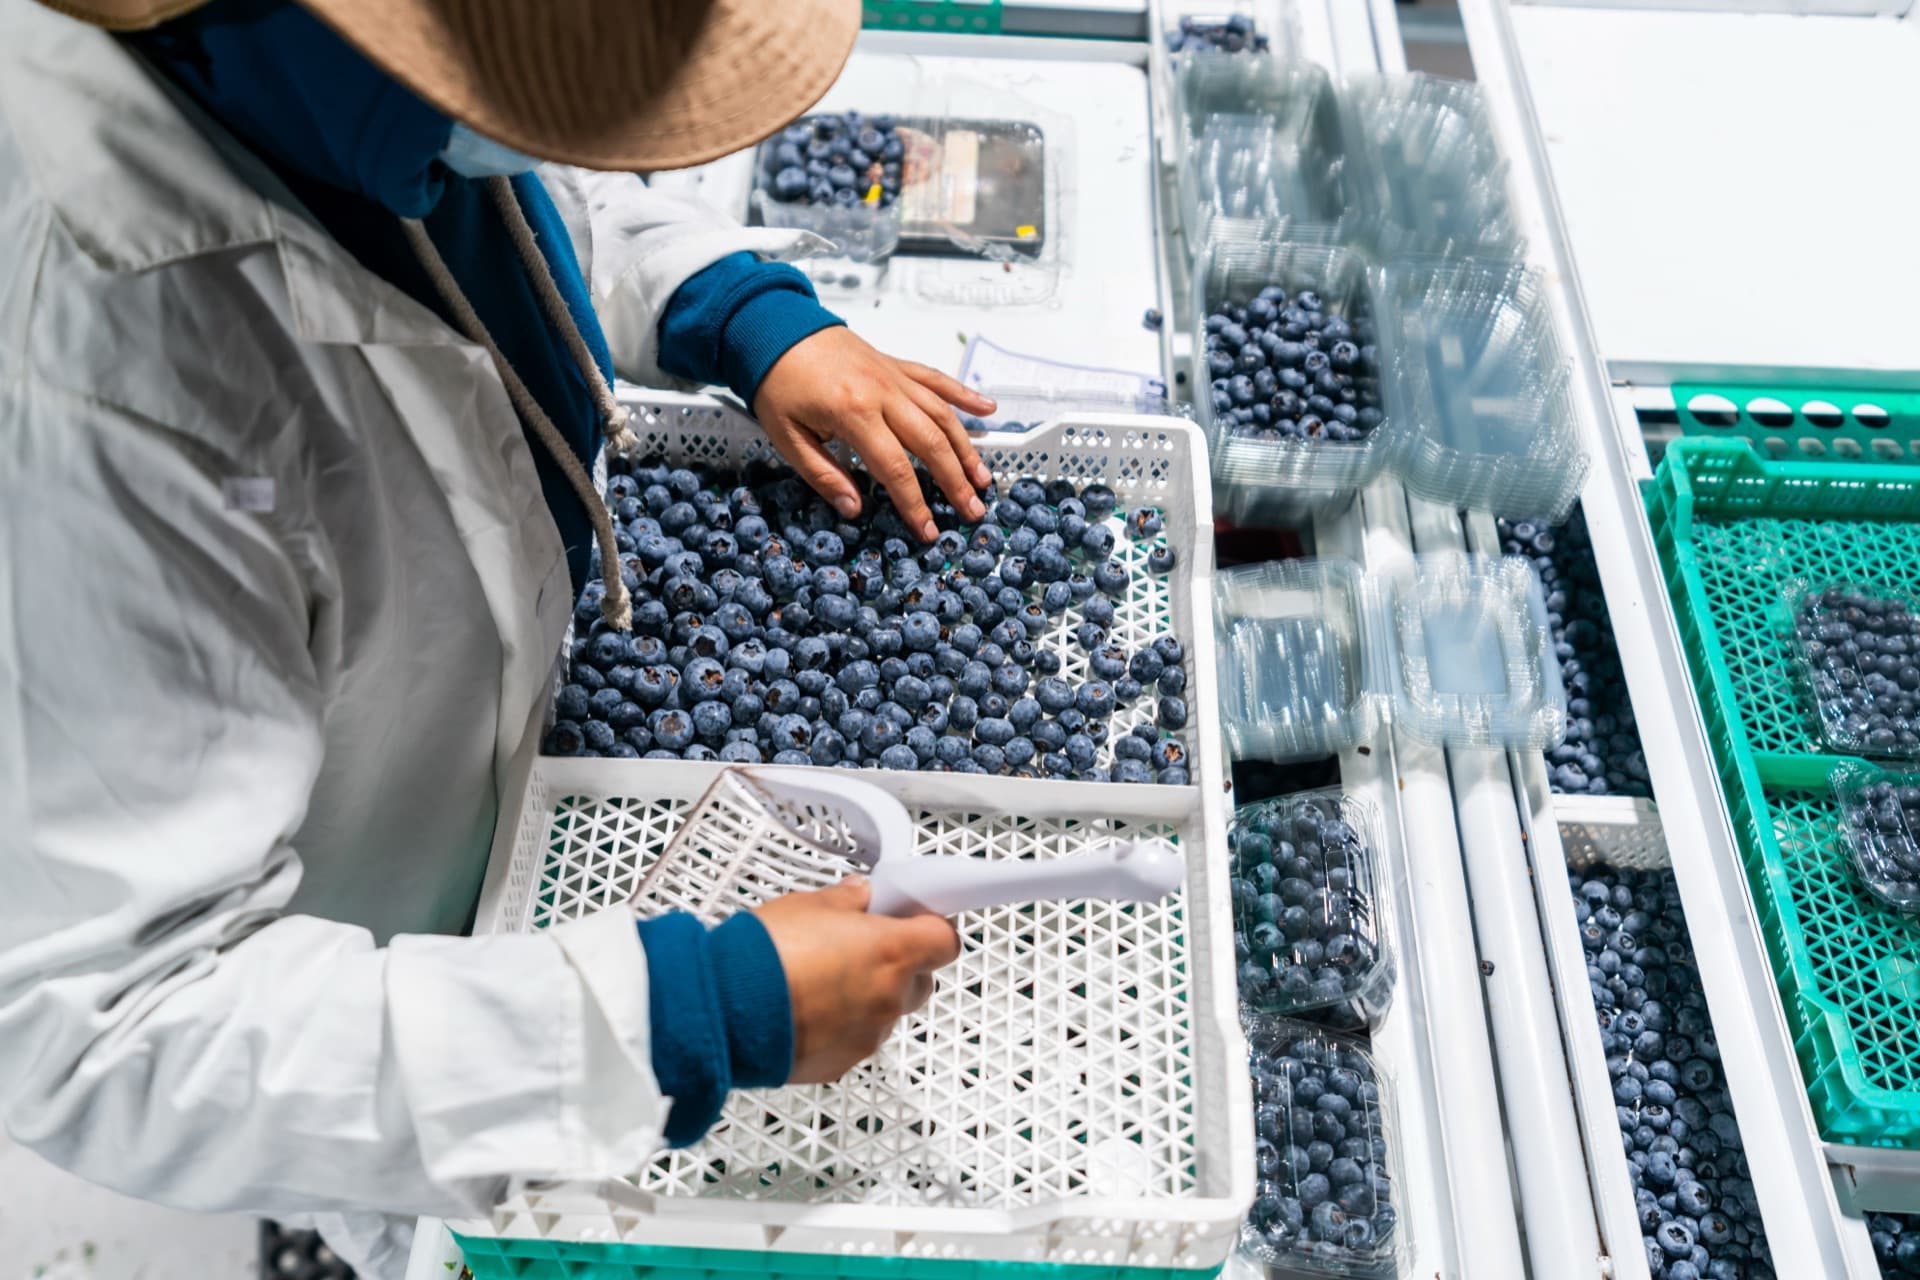
Kernpunten: Computer vision verschuift kwaliteitscontrole van steekproefsgewijze, handmatige inspectie naar continue, geautomatiseerde controle op de volledige productstroom. Detectiegraden van 99%+ zijn haalbaar, maar het succes hangt minder af van het model dan van de beeldkwaliteit, representatieve trainingsdata en de integratie op de lijn. Dit artikel behandelt de implementatie van begin tot eind: datavereisten, cameraopstelling, valse positieven, lijnintegratie en de kosten van een productiewaardige oplossing.
Waarom handmatige inspectie tekortschiet bij schaal
Handmatige kwaliteitsinspectie kent twee structurele beperkingen. Ze is steekproefsgewijs (een inspecteur bekijkt een fractie van de productie) en ze is inconsistent, omdat vermoeidheid en interpretatieverschillen meespelen. Bij hoge volumes betekent dit dat defecten doorglippen en dat de kwaliteit varieert met wie er dienst heeft.
Computer vision pakt beide aan: het inspecteert elk product in plaats van een steekproef, en het doet dat consistent, op basis van dezelfde criteria, 24 uur per dag. Daarmee verschuift kwaliteitscontrole van een achteraf-steekproef naar een real-time controle op de volledige stroom. Voor fabrikanten waar een doorgeglipt defect tot terugroepacties, garantieclaims of reputatieschade leidt, is dat een fundamenteel ander risicoprofiel.
Datavereisten: de bepalende factor
Het grootste deel van het werk zit niet in het model maar in de beelden. Een computer vision-model leert defecten herkennen uit voorbeelden, dus er zijn representatieve, gelabelde beelden nodig van zowel goede producten als van de defecttypen die gedetecteerd moeten worden.
Hoeveel beelden? Voor duidelijke, consistente defecten volstaan soms enkele honderden gelabelde voorbeelden per klasse. Voor zeldzame of subtiele defecten zijn er meer nodig, en juist zeldzame defecten zijn lastig, omdat er per definitie weinig voorbeelden van zijn. Technieken als data-augmentatie (kunstmatig varianten genereren) en transfer learning (voortbouwen op een vooraf getraind model) verlagen die drempel, maar vervangen representatieve data niet.
De praktische consequentie: een serieus traject begint met het verzamelen en labelen van beelden onder gecontroleerde omstandigheden. Een partner die dit overslaat en meteen een vaste prijs noemt, onderschat doorgaans waar de complexiteit zit.
Cameraopstelling en belichting
Een onderschat punt is dat de fysieke opstelling de beeldkwaliteit grotendeels bepaalt: camera's, lenzen en vooral belichting. Gecontroleerde, consistente belichting maakt het verschil tussen een model dat betrouwbaar werkt en een model dat struikelt over schaduwen en reflecties. In de praktijk is het optimaliseren van de opstelling vaak net zo belangrijk als het trainen van het model.
Valse positieven versus gemiste defecten
Geen enkel systeem is perfect, en de kern van een goede implementatie is de afweging tussen twee soorten fouten: een defect missen (vals negatief) en een goed product afkeuren (vals positief). Die afweging is geen technische maar een bedrijfsbeslissing: wat kost een doorgeglipt defect versus een onterecht afgekeurd product?
In een veiligheidskritische toepassing staat het systeem streng afgesteld: liever een goed product afkeuren dan een defect doorlaten. In een kostengedreven toepassing ligt de balans bij de laagste totale foutkosten. Een volwassen implementatie maakt deze afweging expliciet en stelbaar, in plaats van te mikken op een abstracte "nauwkeurigheid".
Integratie op de lijn
Het model is pas waardevol als het ingrijpt in het proces. In de praktijk draait het op edge-hardware bij de lijn, gekoppeld aan de camera's. Dat houdt de latentie laag, zodat de beslissing valt voordat het product doorgaat. De uitkomst stuurt een fysieke actie aan: afkeur, sortering naar een aparte stroom, of een alarm voor een operator. En elke beslissing wordt gelogd, zodat kwaliteit traceerbaar is.
Die koppeling met PLC's, sorteermechanismen en bestaande systemen bepaalt het succes net zozeer als het model. Het is precies de fase waarin een traject vastloopt tussen pilot en productie: het model herkent defecten in een test, maar de integratie met de lijn is niet geregeld.
Wat het kost
De kosten bestaan uit drie delen: hardware (camera's, belichting, edge-compute), modelontwikkeling, en lijnintegratie. Een afgebakende proof-of-concept op één defecttype en één lijn ligt in de orde van enkele duizenden tot tienduizenden euro's en valideert of de beeldkwaliteit en de detectie haalbaar zijn. Een productiewaardige uitrol over meerdere lijnen en defecttypen loopt hoger. De grootste variabele is steevast de beschikbaarheid van representatieve trainingsbeelden. Een overzicht van wat dit soort toepassingen gemiddeld oplevert staat in onze machine learning ROI-benchmark.
De pragmatische route
Begin klein en bewijs eerst de haalbaarheid: één lijn, één of enkele defecttypen, een gecontroleerde opstelling. Spreek vooraf af welke detectiegraad en welke balans tussen valse positieven en gemiste defecten het systeem moet halen om door te gaan. Pas als die drempel gehaald wordt, volgt opschaling naar meer lijnen en defecttypen. Eerst betalen voor zekerheid, dan pas voor schaal.
Is computer vision haalbaar voor de eigen kwaliteitscontrole? Neem contact op en we beoordelen de defecttypen, het beeldmateriaal en de haalbaarheid van een implementatie.
Veelgestelde vragen
Hoe nauwkeurig is computer vision voor kwaliteitscontrole?
Goed getrainde systemen halen detectiegraden van 99%+ op gedefinieerde defecttypen, en inspecteren de volledige productstroom in real time in plaats van een steekproef. De werkelijke nauwkeurigheid hangt af van de beeldkwaliteit, de variatie in defecten en de hoeveelheid representatieve trainingsbeelden. De afweging tussen gemiste defecten en valse positieven wordt afgestemd op de kosten van elk type fout.
Hoeveel beelden zijn er nodig om een computer vision-model te trainen?
Dat hangt af van de complexiteit en variatie van de defecten. Voor duidelijke, consistente defecten volstaan soms enkele honderden gelabelde voorbeelden per klasse; voor zeldzame of subtiele defecten zijn er meer nodig, en helpen technieken als data-augmentatie en transfer learning. Het verzamelen en labelen van representatieve beelden is doorgaans het grootste deel van het werk.
Wat kost een computer vision-kwaliteitscontrolesysteem?
De kosten bestaan uit hardware (camera's, belichting, edge-compute), de modelontwikkeling en de integratie op de lijn. Een afgebakende proof-of-concept op één defecttype ligt in de orde van enkele duizenden tot tienduizenden euro's; een productiewaardige implementatie met lijnintegratie en beheer loopt hoger, afhankelijk van het aantal lijnen en defecttypen. De grootste variabele is de beschikbaarheid van goede trainingsbeelden.
Hoe sluit computer vision aan op de bestaande productielijn?
Het model draait doorgaans op edge-hardware bij de lijn voor lage latentie, gekoppeld aan camera's met gecontroleerde belichting. De uitkomst stuurt een actie aan (afkeur, sortering of een alarm) en wordt gelogd voor traceerbaarheid. De integratie met PLC's en bestaande systemen is net zo bepalend voor het succes als het model zelf.
Ontvang de AI-subsidieradar
Eén e-mail per maand met nieuwe subsidies, deadlines en wat er voor het mkb veranderde. Vijf minuten leestijd.
Uitschrijven met één klik. Nooit spam.
Verder lezen
Gerelateerde artikelen
AI & Machine Learning
Computer vision voor kwaliteitscontrole: wat het kost en oplevert in de maakindustrie
Ontdek hoe computer vision defectdetectie in de maakindustrie verandert, wat implementatie kost en wanneer de investering zich terugverdient.
Lees verder →
AI & Machine Learning
Machine learning ROI-benchmark: wat het oplevert per use-case
Een benchmark van wat de meest voorkomende use-cases van machine learning in de praktijk opleveren, op basis van geanonimiseerde resultaten uit onze projecten en gepubliceerde industriebandbreedtes.
Lees verder →
AI & Machine Learning
Wat we bouwen: machine learning-projecten en hun impact
Een geanonimiseerd overzicht van machine learning-projecten die we in productie brachten, per project de techniek en het resultaat in cijfers: van forecast-correctie met miljoenenbesparing tot aanbevelingsengines en document-intelligentie.
Lees verder →

Laten we kennismaken
Een half uur over waar in de operatie data iets oplevert, en waar niet. Geen slides.



